
GraphRAG 是微软 2024 年 7 月开源的知识图谱增强检索方案,用来弥补传统 RAG 在全局性、总结性问题上的短板。本文从 RAG 与知识图谱两个前置概念讲起,再梳理 GraphRAG 的构建流程与检索方式。
前置知识
RAG
检索增强生成(Retrieval-augmented generation, RAG)是指对大型语言模型输出进行优化,使其能够在生成响应之前引用训练数据来源之外的权威知识库。大型语言模型(LLM)用海量数据进行训练,使用数十亿个参数为回答问题、翻译语言和完成句子等任务生成原始输出。在 LLM 本就强大的功能基础上,RAG 将其扩展为能访问特定领域或组织的内部知识库,所有这些都无需重新训练模型。这是一种经济高效地改进 LLM 输出的方法,让它在各种情境下都能保持相关性、准确性和实用性。
RAG 包含三个主要过程:检索、增强和生成。
- 检索:根据用户的查询内容,从外部知识库获取相关信息。具体而言,将用户的查询通过嵌入模型转换为向量,以便与向量数据库中存储的相关知识进行比对。通过相似性搜索,找出与查询最匹配的前 K 个数据。
- 增强:将用户的查询内容和检索到的相关知识一起嵌入到一个预设的提示词模板中。
- 生成:将经过检索增强的提示词内容输入到大型语言模型中,以生成所需的输出。
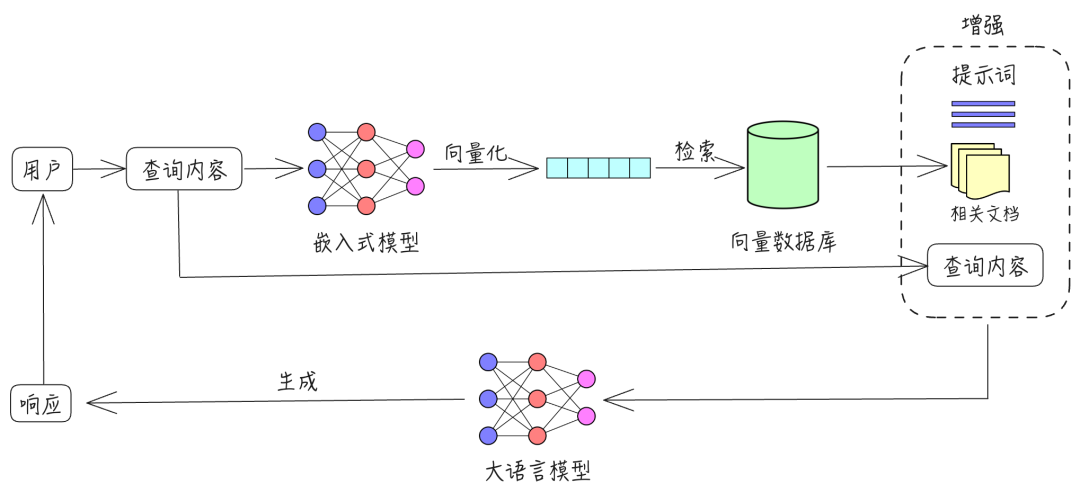
RAG(检索增强生成)旨在缓解甚至解决以下大模型落地应用的痛点:
- 垂直领域知识的幻觉:通过检索外部权威知识库,RAG 可以提供更准确和可靠的领域特定知识,减少生成幻觉的可能性。
- 大模型知识持续更新的困难:无需重新训练模型,RAG 可以通过访问最新的外部知识库,保持输出的时效性和准确性。
- 无法整合长尾语义知识:RAG 能够从广泛的知识库中检索长尾语义知识,从而生成更丰富和全面的响应。
- 可能泄露的训练数据隐私问题:通过使用外部知识库而不是依赖内部训练数据,RAG 减少了隐私泄露的风险。
- 支持更长的上下文:RAG 可以通过检索相关信息,提供更长和更详细的上下文支持,从而提高响应的质量和连贯性。
知识图谱
知识图谱,是结构化的语义知识库,用于以符号形式描述物理世界中的概念及其相互关系。其基本组成单位是“实体-关系-实体”三元组,以及实体及其相关属性-值对,实体间通过关系相互连接,构成网状的知识结构。
知识图谱通常由三个基本要素组成:
实体(Entities):代表现实世界中的具体事物,如人、地点、事件、产品等。每个实体通常具有唯一的标识符。
属性(Attributes):描述实体的特征或属性,如人的姓名、年龄、出生地等。
关系(Relationships):表示实体之间的连接或关联关系,如人之间的亲属关系、地点之间的空间关系等。
知识图谱的建立过程包括知识抽取、知识融合和知识加工等步骤。知识抽取是指从结构化和非结构化数据源中提取出实体、属性和关系的过程。知识建模是将提取出的知识转化为可表示的图谱结构。知识链接是将来自不同数据源的相关知识进行关联和链接,形成一个更加完整和一致的知识图谱。
知识抽取
实体抽取:也称为命名实体识别(Named Entity Recognition, NER),指从源数据中自动识别命名实体,这一步是信息抽取中最基础和关键的部分,因为实体抽取的准确率和召回率对后续知识获取效率和质量影响很大。
关系抽取:经过实体抽取,知识库目前得到的仅是一系列离散的命名实体。为了得到更准确的语义信息,还需要从文本语料中提取出实体之间的关联关系,以此形成网状的知识结构,这种技术则为关系抽取技术。关系抽取的目标是解决实体间语义链接的问题,主要分为开放式实体关系抽取和基于联合推理的实体关系抽取。
属性抽取:从不同信息源中采集特定实体的属性信息。例如针对某个公众人物,可以从网络公开信息中得到其昵称、生日、国籍、教育背景等信息。属性抽取技术能够从各个数据源中汇集属性信息,更完整地表述实体属性。属性抽取主要是针对实体而言的,由于实体的属性可以看成是实体与属性值之间的一种名称性关系,因此可以将实体属性的抽取问题转换为关系抽取问题。基于规则与启发式算法的属性抽取方法能够从半结构化网页中自动抽取相应的属性名称与属性值,还可扩展为一套本体知识库。
知识融合
通过知识抽取的结果可能存在大量冗余和错误信息,形成的结构化信息也会缺乏层次性和逻辑性,因此需要对抽取来的信息做知识融合,消除歧义概念、剔除冗余和错误概念,提升知识质量。
知识融合分为实体链接和知识合并两部分。实体链接(entity linking)指将在文本中抽取出来的实体链接到知识库中正确实体。知识合并指从第三方知识库产品或已有数据化数据中获取知识输入,包括合并外部知识库和合并关系数据库。
知识加工
通过知识抽取、知识融合得到一系列的基本事实表达,离结构化、网络化的知识体系仍有一段距离。因此还需要针对这些事实表达进行知识加工,包括本体构建、知识推理和质量评估。
本体构建(ontology)指对概念建模的规范,以形式化方式明确定义概念之间的联系。在知识图谱中,本体位于模式层,用于描述概念层次体系的知识概念模版。
知识推理指从知识库中已有的实体关系数据经过计算建立新实体关联,从现有知识中发现新知识,拓展和丰富知识网络。
因为知识推理的信息基础来源于开放域的信息抽取,可能存在实体识别错误、关系抽取错误等问题,因此知识推理的质量也可能存在对应问题,需要在入知识库之前,将推理得来的知识进行质量评估。
GraphRAG简介
在介绍什么是GraphRAG之前,先来讨论一下现有RAG技术存在的问题:
虽然RAG可以通过将生成的回答与真实数据相关联来减少幻觉,然而对于较为复杂的信息,由于其“检索”能力的局限性而往往导致回答的准确性不尽人意。RAG检索能力的局限性主要体现在情境理解方面。RAG模型只能检索(Retrieve)到数据集中明显包含有与查询(Query)信息相关的文档或段落,而对于一些不太明显的隐性关系,RAG往往无能为力。例如,对于一些非结构化文本数据, 尽管客观上是存在与查询信息相关的一些信息的,但由于这些信息显现程度不够,RAG要么是给出很粗糙的答案,要么是直接“无法回答”。
GraphRAG仍然沿袭了RAG的思路,即通过检索来增强模型的准确性。不过,与RAG不同的是,GraphRAG还引入了“知识图谱”(Knowledge Graph)技术,以增强模型的“检索”能力,以实现对复杂信息的高效和可靠检索,从而提高LLM问答系统对于复杂信息的答案生成的准确性。
对于类似非结构化文本等复杂信息,挖掘其中的隐性信息关系的方法是“知识图谱”,即将非结构化文本等复杂信息通过实体、关系和属性抽取技术,重新组织成结构化的知识图。这种结构化的格式使得模型能够更好地理解和利用不同信息之间的相互关系,发现其中隐藏的信息连接。同时,这种结构化的检索使得生成答案在语境上更加丰富和准确。应用过程中,GraphRAG首先会利用大语言模型(LLM)对领域知识进行知识图谱化,构建可“图查询”(Graph Querying)的知识图谱数据库。更进一步地,GraphRAG不仅可以将全域知识库分割成多社区模块的知识图谱,还可以构建多层次知识图谱(从下至上信息更加抽象化和“主题化”)。这种多社区模块、多层次知识图谱技术旨在全面充分挖掘知识库中的复杂连接和隐性关系,最终实现对全域范围的各种知识关系在广度和深度上的“连点成线”。
具体检索时,在对知识向量库(Vector Database)进行检索的同时,还将对知识图谱数据库进行检索,并将检索到的知识图谱信息和知识向量信息进行集成转化为“提示词”(Prompt),再由LLM生成答案。
GraphRAG实现流程
GraphRAG的基本流程包括索引(Index) 和 查询(Query) 两部分,其中:
索引:
- 输入语料库分割成一系列文本单元(TextUnit),作为流程其余部分的可分析单元,并在我们的输出中提供细粒度的引用;
- 使用LLM从文本单元中提取所有实体(Entity)、关系(Relationship)和关键声明(Claim);
- 使用莱顿算法对图表进行层次聚类;
- 自下而上生成每个社区(Community)及其成员的摘要。这有助于从整体上理解数据集。
查询:
在查询时,这些结构用于在回答问题时为 LLM 上下文窗口提供材料。主要查询模式包括:
- 通过利用社区摘要,对关于语料库的整体问题进行全局搜索(Global Search)
- 通过散布到邻居和相关概念来对特定实体进行推理的本地搜索(Local Search)
下面进行详细介绍:
索引
索引的默认总体流程如下图:
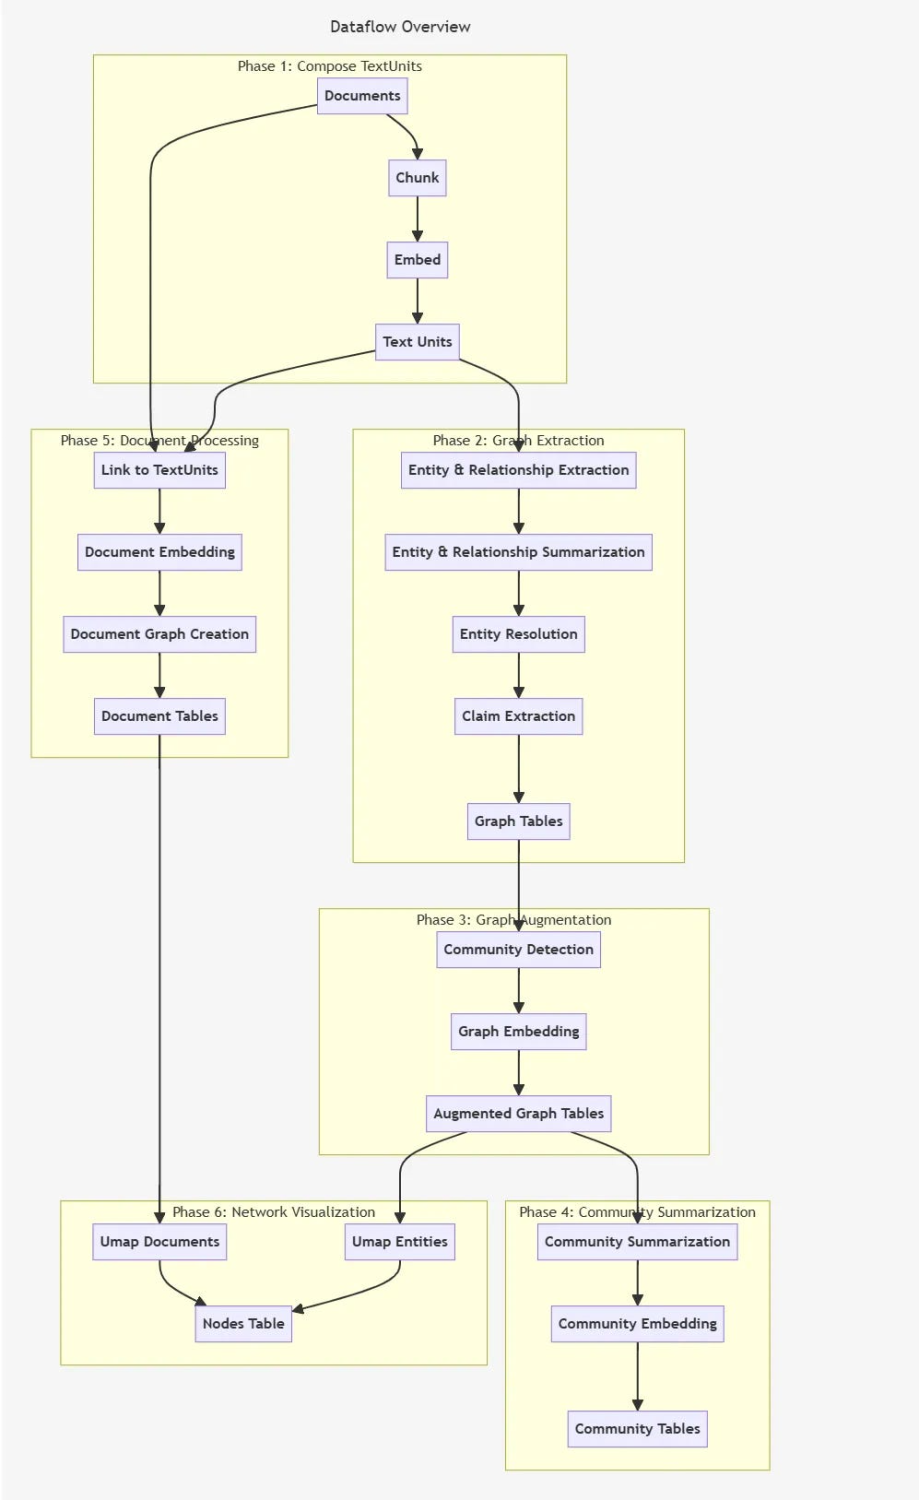
步骤一:处理文本单元
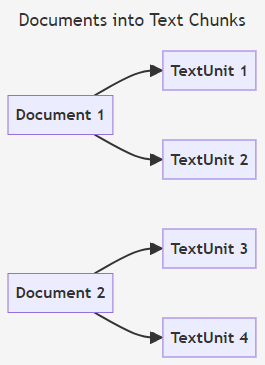
步骤一的任务是将输入的文档转换为 TextUnits。这些 TextUnits 是用于图谱抽取技术的基本文本块,并且可以作为知识项的来源引用。
1. 文档分块(Chunking)
- 文档首先被分割成较小的文本块,这些文本块的大小通常以token数来衡量,默认情况下,每个块大约包含300个token;
- 块的大小是用户可配置的,较大的块可能无法提供足够精细的文本参考,可能导致低质量的输出,但是可以加快处理速度
2. 文本嵌入(Embedding)
- 每个文本块会被转换为嵌入表示(embedding)。这些嵌入向量将捕捉文本块的语义信息,并在后续阶段用于进一步的处理和图谱生成。
3. 块和文档的映射(Mapping Chunks to Documents)
- 文档和文本单元之间一般存在严格的一对多关系,在极少数情况下,这可以变成多对多关系(当文档很短并且我们需要其中几个来组成一个有意义的分析单元)。
步骤一的主要目的是通过将文档分块并对每个块进行嵌入,创建基础数据单元,供后续的实体和关系提取使用。这些 TextUnits 是整个流程中非常基础的单位,在接下来的各个阶段都会反复使用。
步骤二:图提取
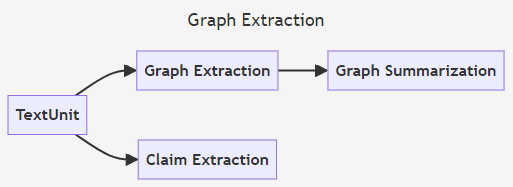
在第二阶段,系统会对每个 TextUnit 进行分析,提取出图谱的基本元素:实体(Entities)、关系(Relationships) 和 声明(Claims)。这一阶段的目标是从文本中生成与知识图谱相关的实体和关系,并将这些元素汇总为结构化的表示。
1. 实体和关系抽取(Entity & Relationship Extraction)
- 在图谱抽取的第一个步骤中,系统会处理每个 TextUnit,从原始文本中提取出实体和关系。
- 输出每个 TextUnit 的子图,包含一个实体列表(带有名称、类型和描述)和关系列表(带有源、目标和描述)。
- 系统会将具有相同名称和类型的实体合并在一起,并且将源和目标相同的关系也进行合并
2. 实体和关系摘要(Entity & Relationship Summarization)
- 在生成了实体和关系的图谱后,系统会对每个实体和关系进行总结,生成简洁的描述。这一阶段的目的是通过总结来优化图谱信息,使得每个实体和关系都有一个简短的、富有信息的描述。
- 总结过程是通过LLM(大语言模型)实现的,它能够从原始描述中提炼出最重要的信息,确保图谱保持简洁且有效。
3. 实体消歧(Entity Resolution)(默认不开启)
- 实体消歧的目标是解决那些代表相同真实世界实体但名称不同的实体。例如,”IBM” 和 “International Business Machines” 可能指代同一个公司。
- 当前的实体消歧并未默认启用,因为它是一个较为复杂的过程,而且当前实现较为破坏性。在未来,系统可能会通过为实体变体之间创建边来指示它们是同一实体的不同版本,从而实现非破坏性的实体消歧。
4. 声明抽取(Claim Extraction)
- 作为独立的工作流,系统还会从 TextUnit 中提取声明。这些声明代表了带有评估状态和时间限制的正向事实陈述。
- 抽取出的声明被作为主要结果,称为协变量(Covariates),并在后续阶段进一步处理。
- 为图谱中的实体和关系提供了额外的上下文。例如,不仅描述某个实体存在的事实,还可以描述该实体在某个时间点或特定条件下的状态。
- 通过声明,知识图谱可以从静态信息扩展到动态信息。声明可以描述某些事实是如何随着时间变化的。
- 声明可以用来丰富图谱中的推理能力。例如,特定声明可能会影响到系统对某些查询的推理过程。
- 解释因果关系:例如,特定的市场条件(协变量)可能解释了公司业绩的变化。
步骤三:图谱增强
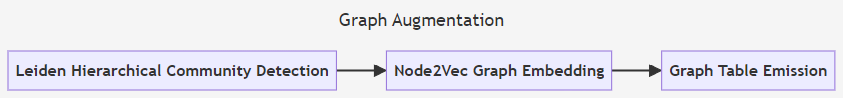
在图谱增强阶段,系统已经拥有了一个可用的实体和关系图谱,接下来需要进一步理解图谱的社区结构,并通过额外的信息来增强图谱。这个阶段通过社区检测(Community Detection)和图谱嵌入(Graph Embedding)两个步骤来完成。
1. 社区检测(Community Detection)
- 目标:使用Leiden层次化社区检测算法(Leiden Hierarchical Community Detection)来生成图谱中实体的社区层次结构。这个算法会对图谱进行递归的社区聚类,直到达到某个社区规模的阈值。
- 作用:社区检测有助于理解图谱的社区结构,帮助我们在不同的粒度级别上导航和总结图谱。这种社区结构是显式的,即可以清楚地看到图谱中哪些节点属于同一个社区,它们如何聚集在一起。
2. 图谱嵌入(Graph Embedding)
- 目标:通过Node2Vec算法生成图谱的向量表示(Graph Embedding)。Node2Vec是一种将图谱节点映射到向量空间的技术,使得图谱中的节点和关系能够在高维向量空间中表示。
- 作用:图谱嵌入有助于理解图谱的隐式结构,提供一个额外的向量空间,可以在查询阶段用于搜索相关概念。通过这种嵌入表示,系统可以在语义上更加高效地搜索图谱中的相关节点和关系。
3. 图谱表输出(Graph Tables Emission)
- 最终输出:一旦图谱增强步骤完成,系统会输出最终的实体和关系表(Entities and Relationships Tables)。这些表格在完成增强处理之后,还会进一步进行文本嵌入处理,使得它们可以用于后续的查询和推理。
步骤四:社区总结

在第四阶段,系统已经有了一个包含实体、关系和社区层次结构的功能性图谱,并且完成了通过Node2Vec生成的图嵌入。接下来,系统会基于这些社区数据生成社区报告,从而提供图谱在不同粒度级别上的总结。
1. 生成社区报告(Generate Community Reports):
- 目标:通过LLM(大语言模型),系统生成每个社区的总结报告。这些报告提供了每个社区内部的关键信息,以及对图谱的具体理解。
- 作用:通过生成这些社区报告,系统可以更好地理解图谱中的不同社区是如何形成的,并为后续的推理或查询提供不同层次的总结视角。例如,如果某个社区位于图谱的顶层,那么该报告可能会涵盖整个图谱;而较低层级的社区报告则更关注局部簇。
2. 总结社区报告(Summarize Community Reports):
- 目标:在这一步,系统会进一步总结社区报告,以生成简洁版本的报告。这些简洁报告会通过LLM来生成,提供对图谱的概览或详细分析,取决于报告所聚焦的社区粒度。
- 作用:这些简洁报告有助于系统从更高的层次理解图谱中的社区,帮助在后续的推理或查询过程中快速获取与特定社区相关的信息。
3. 社区嵌入(Community Embedding):
- 目标:通过对社区报告及其摘要生成向量表示(embedding),系统可以将这些社区嵌入到向量空间中。
- 作用:社区嵌入为后续的查询提供了一个额外的向量空间表示,使得系统能够根据社区的语义信息在查询时更高效地搜索相关社区内容。这样,不仅实体和关系可以被嵌入,社区本身也拥有了向量表示。
4. 社区表输出(Community Tables Emission):
- 目标:一旦社区总结和嵌入步骤完成,系统会进行一些记录整理工作,最终输出社区报告表(Community Reports Tables)。
- 作用:这些表格包含了系统生成的社区报告及其嵌入表示,供后续查询、分析和推理使用。
步骤五:文档处理阶段
在这个阶段,系统开始处理文档数据,并生成知识模型中的Documents表。这一阶段的任务是将文档与之前创建的 TextUnits 相关联,并生成文档的向量表示。文档处理完成后,系统会输出Documents表,供知识模型进一步使用。
1. 字段增强(Augment with Columns, CSV Only):
- 目标:如果系统正在处理CSV格式的数据,你可以为文档输出配置额外的字段。这些字段需要在输入的CSV表格中存在。这个步骤允许你根据需要添加额外的元数据,以增强文档的表示。
- 作用:通过添加额外的字段,系统可以丰富文档的结构化信息,使得后续的推理或分析能够利用更多的上下文。
2. 链接到文本单元(Link to TextUnits):
- 目标:在这一步,系统将每个文档与之前创建的 TextUnits(文本单元)链接起来。这使得系统能够理解哪些文档与哪些 TextUnits 相关联,反之亦然。
- 作用:这种链接确保了文档的上下文可以通过 TextUnits 进行扩展,从而为文档提供更详细的语义信息。系统可以利用这些链接在文档和文本块之间建立关联,以便在后续的查询或推理中充分利用这些信息。
3. 文档嵌入(Document Embedding):
- 目标:系统生成文档的向量表示(embedding)。具体步骤包括:将文档重新分块(不重叠的块),然后为每个块生成嵌入表示。接着,系统会对这些块的嵌入进行加权平均(根据token数量)来生成整个文档的嵌入。
- 作用:通过生成文档的嵌入表示,系统可以在向量空间中理解文档的语义信息。这一步允许系统在查询时使用文档的嵌入表示来进行相似性搜索或语义推理。
4. 文档表输出(Documents Table Emission):
- 目标:在完成文档处理之后,系统会输出 Documents 表。这张表格包含了所有处理过的文档及其嵌入表示,并将这些文档与之前的 TextUnits 关联起来。
- 作用:Documents 表是知识模型中的一个重要部分,它包含了文档的语义表示和结构化信息,供后续的查询、推理或分析使用。
步骤六:可视化
此步骤会将构建好的图谱导出,便于用图形化工具查看实体、关系和社区结构。
查询
本地搜索(Local Search)

给定用户查询和(可选)对话历史记录,本地搜索方法会从知识图谱中识别出一组与用户输入在语义上相关的实体。这些实体可作为知识图谱的访问点,从而提取更多相关详细信息,例如连接实体、关系、实体协变量和社区报告。此外,它还会从与已识别实体相关的原始输入文档中提取相关文本块。然后对这些候选数据源进行优先排序和筛选,以适应预定义大小的单个上下文窗口,该窗口用于生成对用户查询的响应。
问题生成(Question Generation)
在给定先前用户问题列表的情况下,问题生成使用与本地搜索中相同的上下文构建方法来提取相关结构化和非结构化数据并对其进行优先排序,包括实体、关系、协变量、社区报告和原始文本块。然后将这些数据记录放入单个LLM提示中,以生成代表数据中最重要或最紧急的信息内容或主题的候选后续问题。
全局搜索(Global Search)
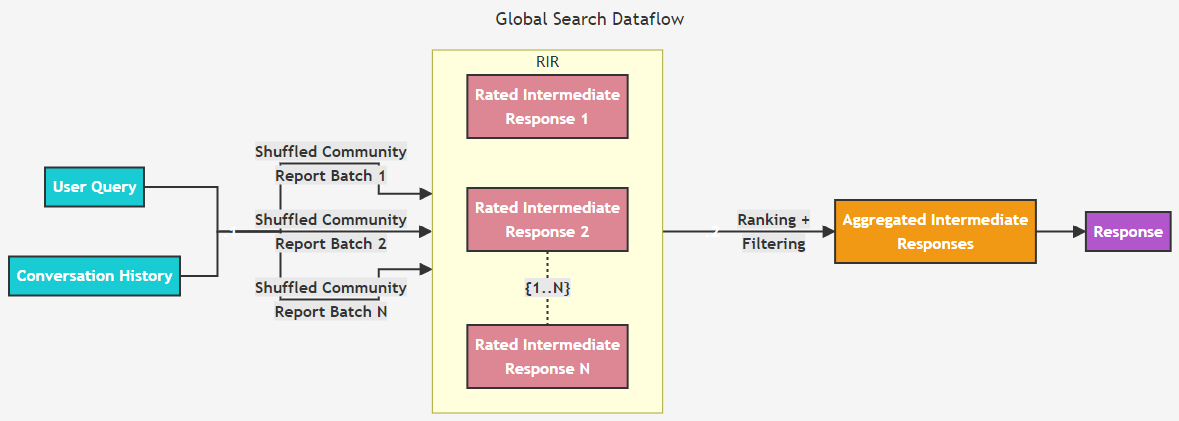
全局搜索方法通过以 map-reduce 方式搜索所有 AI 生成的社区报告来生成答案。这是一种资源密集型方法,但通常可以很好地回答需要了解整个数据集的问题。
给定用户查询和(可选)对话历史记录,全局搜索方法使用来自图的社区层次结构指定级别的 LLM 生成的社区报告集合作为上下文数据,以 map-reduce 方式生成响应。在此 map 步骤中,社区报告被分割成预定义大小的文本块。然后使用每个文本块生成一个中间响应,其中包含一个要点列表,每个要点都附有数字评级,表明该要点的重要性。在此步骤中,reduce 从中间响应中筛选出的一组最重要的要点被汇总并用作上下文来生成最终响应。
全局搜索响应的质量可能在很大程度上受到选择用于获取社区报告的社区层级的影响。较低层级的报告较为详细,因此往往会产生更全面的响应,但由于报告数量较多,生成最终响应所需的时间和 LLM 资源也可能会增多。
评论讨论